Ch. 4 : Bases de données et SGBD
Cours – Partie 1
1 Données et bases de données
Définition 1 (Donnée)
Une donnée est une valeur numérisée décrivant de manière élémentaire un fait, une mesure, une réalité.
Exemples : le nom de l’auteur, l’âge du capitaine, le titre du livre…
Les données décrivent des entités du monde réel, elles-mêmes associées les unes aux autres. Par exemple, Nicolas Bouvier est un écrivain suisse, auteur du récit de voyage culte « L’Usage du monde » paru en 1963 : deux entités, liées par la notion d’auteur.
Une base de données est un ensemble (potentiellement volumineux, mais pas forcément) de telles informations conformes à une structure prédéfinie au moment de la conception, avec, de plus, une caractéristique essentielle : on souhaite les mémoriser de manière persistante. La persistance désigne la capacité d’une base à exister indépendamment des applications qui la manipulent, ou du système qui l’héberge. On peut arrêter toutes les machines un soir et retrouver la base de données le lendemain. Cela implique qu’une base est toujours stockée sur un support, comme les disques magnétiques, qui préserve son contenu même en l’absence d’alimentation électrique.
Définition 2 (Base de données)
Une base de données est un ensemble d’informations structurées mémorisées sur un support persistant.
2 Peut-on se contenter de fichiers ?
Un fichier de base de données a nécessairement une structure qui permet, d’une part, de distinguer les données les unes des autres et, d’autre part, de représenter leurs liens.
Prenons l’exemple des fichiers CSV, l’une des structures les plus simples et les plus répandues, sur lesquels nous avons travaillé en première. Dans un fichier CSV, les données élémentaires sont représentées par des « champs » délimités par des virgules ou des points-virgules. Les champs sont associés les uns aux autres par le simple fait d’être placés sur une même ligne. Les lignes, en revanche, sont indépendantes les unes des autres : on peut placer autant de lignes que l’on veut dans un fichier, et même changer leur ordre, sans que cela modifie en quoi que ce soit l’information représentée.
Voici nos données représentées en CSV :
"Bouvier" ; "Nicolas" ; "L'Usage du monde" ; 1963On comprend bien que le premier champ est le nom, le second le prénom, etc. Il paraît donc cohérent d’ajouter de nouvelles lignes comme :
"Bouvier" ; "Nicolas" ; "L'Usage du monde" ; 1963
"Stevenson" ; "Robert Louis" ; "Voyage avec un âne dans les Cévennes" ; 1879
On a donné une structure régulière à nos informations, ce qui va permettre de les interroger et de les manipuler avec précision. On les stocke dans un fichier sur disque : nous sommes en cours de constitution d’une véritable base de données. On peut généraliser ce constat : une base de données est toujours un ensemble de fichiers, stockés sur une mémoire externe comme un disque, dont le contenu obéit à certaines règles de structuration.
Peut-on se satisfaire de cette solution et construire des applications en s’appuyant directement sur des fichiers structurés, par exemple des fichiers CSV ? Dans une telle situation, chaque utilisateur applique des programmes au fichier pour en extraire des données, les modifier, en créer. Cette approche soulève de nombreuses difficultés :
- Lourdeur d’accès aux données. Pour chaque accès, même le plus simple, il faudrait écrire un programme adapté à la structure du fichier. La production et la maintenance de tels programmes seraient extrêmement coûteuses.
- Risques élevés pour l’intégrité et la sécurité. Si tout programmeur peut accéder directement aux fichiers, il est impossible de garantir la sécurité et l’intégrité des données. Quelqu’un peut très bien, en toute bonne foi, faire une fausse manœuvre qui rend le fichier illisible.
- Pas de contrôle de concurrence. Lorsque plusieurs utilisateurs accèdent aux mêmes fichiers, des problèmes de concurrence d’accès se posent, notamment pour les mises à jour. Comment gérer, par exemple, la situation où deux utilisateurs souhaitent ajouter une ligne au fichier en même temps ?
- Performances. Tant qu’un fichier ne contient que quelques centaines de lignes, on peut supposer que les performances ne posent pas de problème. Mais que faire quand on atteint le gigaoctet (1 000 mégaoctets), ou même le téraoctet (1 000 gigaoctets) ? Maintenir des performances acceptables suppose la mise en œuvre d’algorithmes et de structures de données demandant des compétences très avancées, probablement hors de portée du développeur d’application qui a, de toute façon, mieux à faire.
3 Les systèmes de gestion de bases de données
Pour surmonter ces problèmes, on met en place des systèmes complexes capables d’offrir à la fois un accès simple, sécurisé et performant au contenu d’une base, et d’accomplir le tour de force de satisfaire de tels accès pour des dizaines, des centaines, voire des milliers d’utilisateurs simultanés, le tout en garantissant l’intégrité de la base, même en cas de panne. De tels systèmes sont appelés Systèmes de Gestion de Bases de Données, ou SGBD.
Définition 3 (SGBD)
Un Système de Gestion de Bases de Données (SGBD) est un système informatique qui assure la gestion de l’ensemble des informations stockées dans une base de données. Il prend en charge, notamment, les deux grandes fonctionnalités suivantes :
- l’accès aux fichiers de la base, garantissant leur intégrité, contrôlant les opérations concurrentes, optimisant les recherches et les mises à jour ;
- les interactions avec les applications et les utilisateurs, grâce à des langages d’interrogation et de manipulation à haut niveau d’abstraction.
Avec un SGBD, les applications n’ont plus jamais accès directement aux fichiers, et ne savent d’ailleurs même pas qu’ils existent, quelle est leur structure et où ils sont situés.
Les quatre services rendus par un SGBD relationnel
| Service | Ce qu’il garantit | Difficulté des fichiers qu’il résout |
|---|---|---|
| Persistance des données | Les données sont stockées durablement sur disque et retrouvées intactes, même après un arrêt ou une panne. | Fichier rendu illisible par une fausse manœuvre. |
| Gestion des accès concurrents | Plusieurs utilisateurs peuvent lire et modifier la base en même temps sans la rendre incohérente. | Pas de contrôle de concurrence. |
| Efficacité de traitement des requêtes | Les recherches et les mises à jour restent rapides, même sur de très grosses bases. | Performances ; lourdeur d’accès (grâce à un langage de requêtes, SQL). |
| Sécurisation des accès | Seules les personnes autorisées accèdent aux données, avec des droits adaptés (lecture, modification…). | Intégrité et sécurité : tout programmeur accède directement aux fichiers. |
Il s’agit de comprendre le rôle et les enjeux de ces services, sans détailler leur fonctionnement interne.
3.1 Architecture client-serveur
L’architecture classique est celle illustrée par la figure ci-dessous. Le SGBD apparaît sous la forme d’un serveur, c’est-à-dire d’un processus informatique prêt à communiquer avec d’autres (les « clients ») via le réseau. Ce serveur est hébergé sur une machine (la « machine serveur ») et est le seul à pouvoir accéder aux fichiers contenant les données, ces fichiers étant le plus souvent stockés sur le disque de la machine serveur.
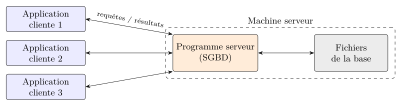
Les applications utilisateurs accèdent donc à la base via le programme serveur auquel elles sont connectées. Elles lui transmettent des commandes (d’où le nom d’applications clientes) que le serveur se charge d’appliquer. Ces applications bénéficient ainsi des puissants algorithmes implantés par le SGBD, comme la capacité à gérer les accès concurrents ou à satisfaire efficacement des recherches portant sur de très grosses bases. Cette architecture est à peu près universellement adoptée par les SGBD ; le vocabulaire associé est donc très important à retenir.
Définition 4 (Programme serveur et clients)
Programme serveur. Un SGBD est instancié sur une machine sous la forme d’un programme serveur qui gère une ou plusieurs bases de données, chacune constituée de fichiers stockés sur disque. Le programme serveur est seul responsable de tous les accès à une base, et de l’utilisation des ressources (mémoire, disques) qui servent de support à ces accès.
Clients (programmes). Les programmes (ou applications) clients se connectent au programme serveur via le réseau, lui transmettent des requêtes et reçoivent des données en retour. Ils ne disposent d’aucune information directe sur la base.
Remarque. Dans ce cours, nous utiliserons SQLite, qui fait figure d’exception : il n’y a pas de programme serveur, et la base est un simple fichier lu et modifié directement par une bibliothèque intégrée à l’application (par exemple DB Browser). SQLite offre le même langage SQL que les autres SGBD, mais avec des capacités plus limitées pour les accès concurrents en écriture. C’est un outil idéal pour apprendre : les concepts restent les mêmes qu’avec un SGBD client-serveur comme MySQL ou PostgreSQL.
3.2 Pour aller plus loin : niveaux d’abstraction
Le fait que le serveur s’interpose entre les fichiers et les programmes clients a une conséquence importante : les clients, n’ayant pas accès aux fichiers, ne voient les données que sous la forme que le serveur veut bien leur présenter. Pour nous, ce sera sous forme de tables : c’est le modèle relationnel. On distingue ainsi deux niveaux d’abstraction.
- Le niveau physique est celui du codage des données dans des fichiers stockés sur disque.
- Le niveau logique est celui de la représentation des données dans des structures abstraites (pour nous, des tables) proposées aux applications clientes, obtenues par conversion du niveau physique.
Les programmes clients ne voient que le niveau logique. Le serveur est chargé du niveau physique, de la conversion vers le niveau logique et de toute la machinerie qui permet au système de fonctionner (mémoire, disques, algorithmes et structures de données). Les deux niveaux sont en grande partie indépendants : on peut modifier complètement l’organisation physique sans rien changer aux applications. Cette indépendance logique-physique est très précieuse pour l’administration des bases de données.
4 Le langage SQL
Un langage est nécessaire pour interagir avec les données (insérer, modifier, détruire, protéger…) : il permet de construire les commandes transmises au serveur. Le modèle relationnel s’est construit sur des bases formelles (mathématiques) rigoureuses, ce qui explique en grande partie sa robustesse et sa stabilité depuis les travaux qui l’ont élaboré dans les années 1970-1980.
Le langage SQL (Structured Query Language) est utilisé depuis les années 1970 dans tous les systèmes relationnels. Le terme SQL désigne plus qu’un langage d’interrogation, même si c’est son principal aspect : la norme couvre également les mises à jour, la définition des tables, les contraintes portant sur les données et les droits d’accès. SQL est donc le langage à connaître pour interagir avec un système relationnel.
À retenir
- Une base de données est un ensemble d’informations structurées, mémorisées sur un support persistant.
- Manipuler directement des fichiers pose des problèmes de lourdeur d’accès, d’intégrité et de sécurité, de concurrence et de performances.
- Un SGBD résout ces problèmes. Ses services : persistance des données, gestion des accès concurrents, efficacité de traitement des requêtes, sécurisation des accès.
- Dans l’architecture classique, des clients envoient des requêtes à un programme serveur qui est seul à accéder aux fichiers de la base.
- Les clients ne voient que le niveau logique : des tables (modèle relationnel), interrogées avec le langage SQL.